出于种种工程限制,大算力芯片总是要分块的。深度学习处理器诞生后不久,多核结构就出现了。多个矩阵核之间如何组织成整体?我所见的方案,都是凭着朴素的工程直觉,拿各种万能的 NoC 和网络拓扑套上去,然后把难题丢给软件。硬件结构就那么些,精髓基本上是只要能连起来就算胜利。
我一直认为这是芯片中不优雅的地方。过去我做的分形系列工作,出发点也基本上在于把这些丢给软件的难题包装一下,藏起来。就像把一团乱麻塞进柜子里,然后声称解决了问题。
沿着分形理论继续推演、想要证明一些定理时,我用到了 Leslie Valiant 的通用电路(Universal Circuit,UC)。这玩意在门级粒度上的开销非常恐怖。为了让逻辑门能够任意组合,配套的路由开关要有几十倍的大小——生动诠释了图灵税这一概念。由于巨大的开销,UC一直只是一个理论工具,自1976年提出以来一直被视作是不会有实用意义的电路结构,因此也并不广为人知。
但是,一项朴素的直觉告诉我,它在深度学习里真的会有用。深度学习处理器的基本内涵,便是以较大块的矩阵运算为原子单位。在一群大块脉动阵列的对照下,UC 的开销可能会被稀释到近乎可忽略的程度。这将是一个具备优良性质的新型多核互联结构:对节点数和入出度受限的 DAG 实现任意无阻塞连接,具有静态、确定性的行为,不需要 FIFO 和动态路由,路由选择结构的规模又达到了理论上的渐近最优。
这项研究在 2022 年开始了。第一个负责将它实现的是樊哲,但他当时即将博士毕业,压力很大,没能把这项工作做完(现在他是寒武纪的工程师)。此后,研究搁置了相当长一段时间,直到今年杨志浩完成了它,发表在 MICRO 2026。
它的基本假设是这样的。无论想要在大的多核架构上同时映射哪一组运算,各个任务在一轮协作中的运算流图都应当是有向无环图(DAG)。若干相互独立的 DAG 合在一起,仍然是一个 DAG。所以,只要一个图结构能够对规模和入出度受限的任意 DAG 实现通用嵌入,便能支持任意一组这样的运算所需的互联。
论文在电路中实现了一套入度、出度上限均为 2 的边通用图(Edge-Universal Graph,EUG),用它代替需要动态路由的 NoC。芯片上任意一组零散的空闲核,都可以按拓扑顺序安排运算,重新组织起来,构成一个虚拟的大块运算阵列。相比 Mesh、Torus 等受限互联,它采用无阻塞的线路交换,不会因为缺少转发通路而留下不可利用的碎片;相比 Crossbar、Butterfly,它只需支持拓扑顺序上的前向转发,省掉了架构上实质用不到的反向连接,开销显著更低。这在多租用场景下非常有效,我们在撰写论文时瞄准了这样的场景。
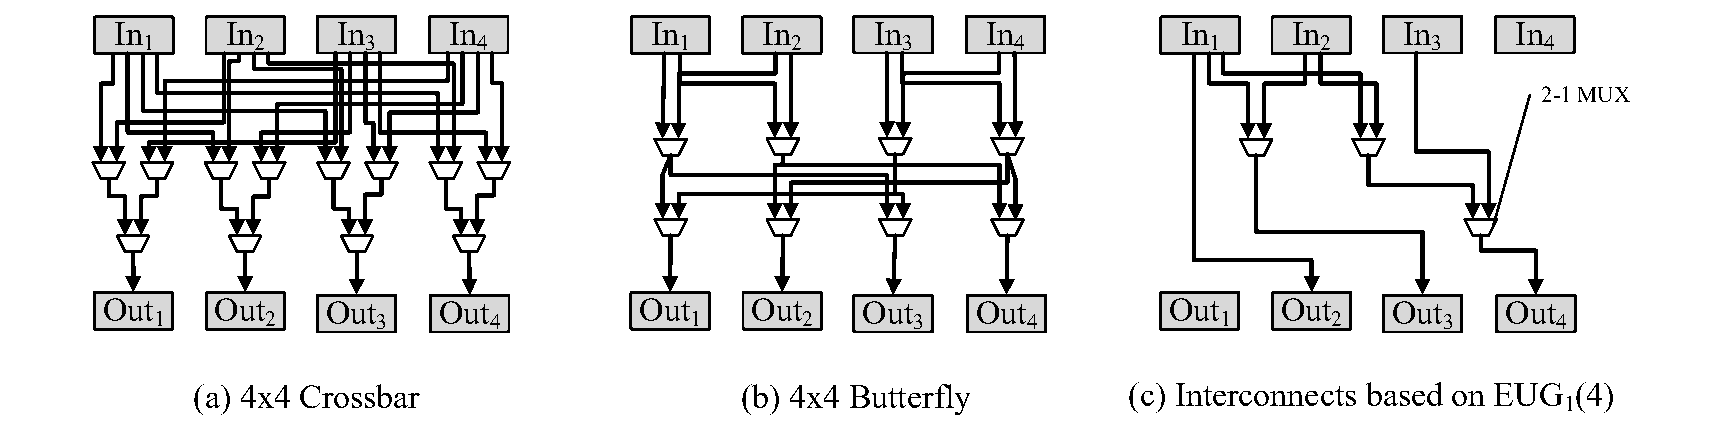
一个四节点、入出度上限为 1 的例子:右侧的 EUG 只需要三个二选一多路选择器。实际实现采用的是十六节点、入出度上限为 2 的 EUG。
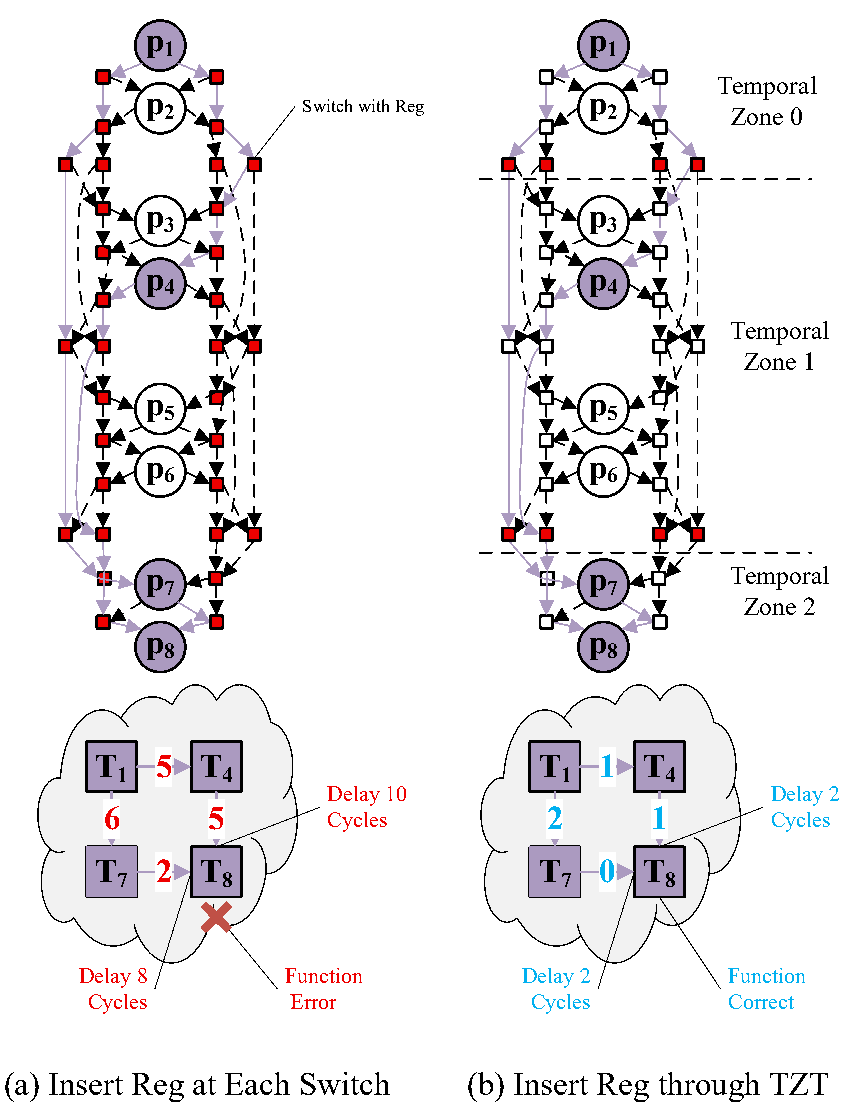
论文还应用了重定时引理来分析时序,指导该在哪里插入寄存器。这样既能截断长组合路径,又能保证不同运算图嵌入后,互联新增的延迟不会破坏原有的数据同步关系。
在物理实现上,我们沿着希尔伯特曲线安排计算核的位置,并旋转部分计算核,缩短同一流水段内的连线。最终实现包含 16 个核,每个核是一块 32×32 的脉动阵列及其配套的存储和控制电路。在 FreePDK45 下完成布局布线后,核间网络的关键路径为 2 ns,核内则为 2.5 ns,互联没有成为频率瓶颈。网络切换到一套新配置只需要 9 个周期,执行中的任务只要通信需求不变,就不必停下来等待。
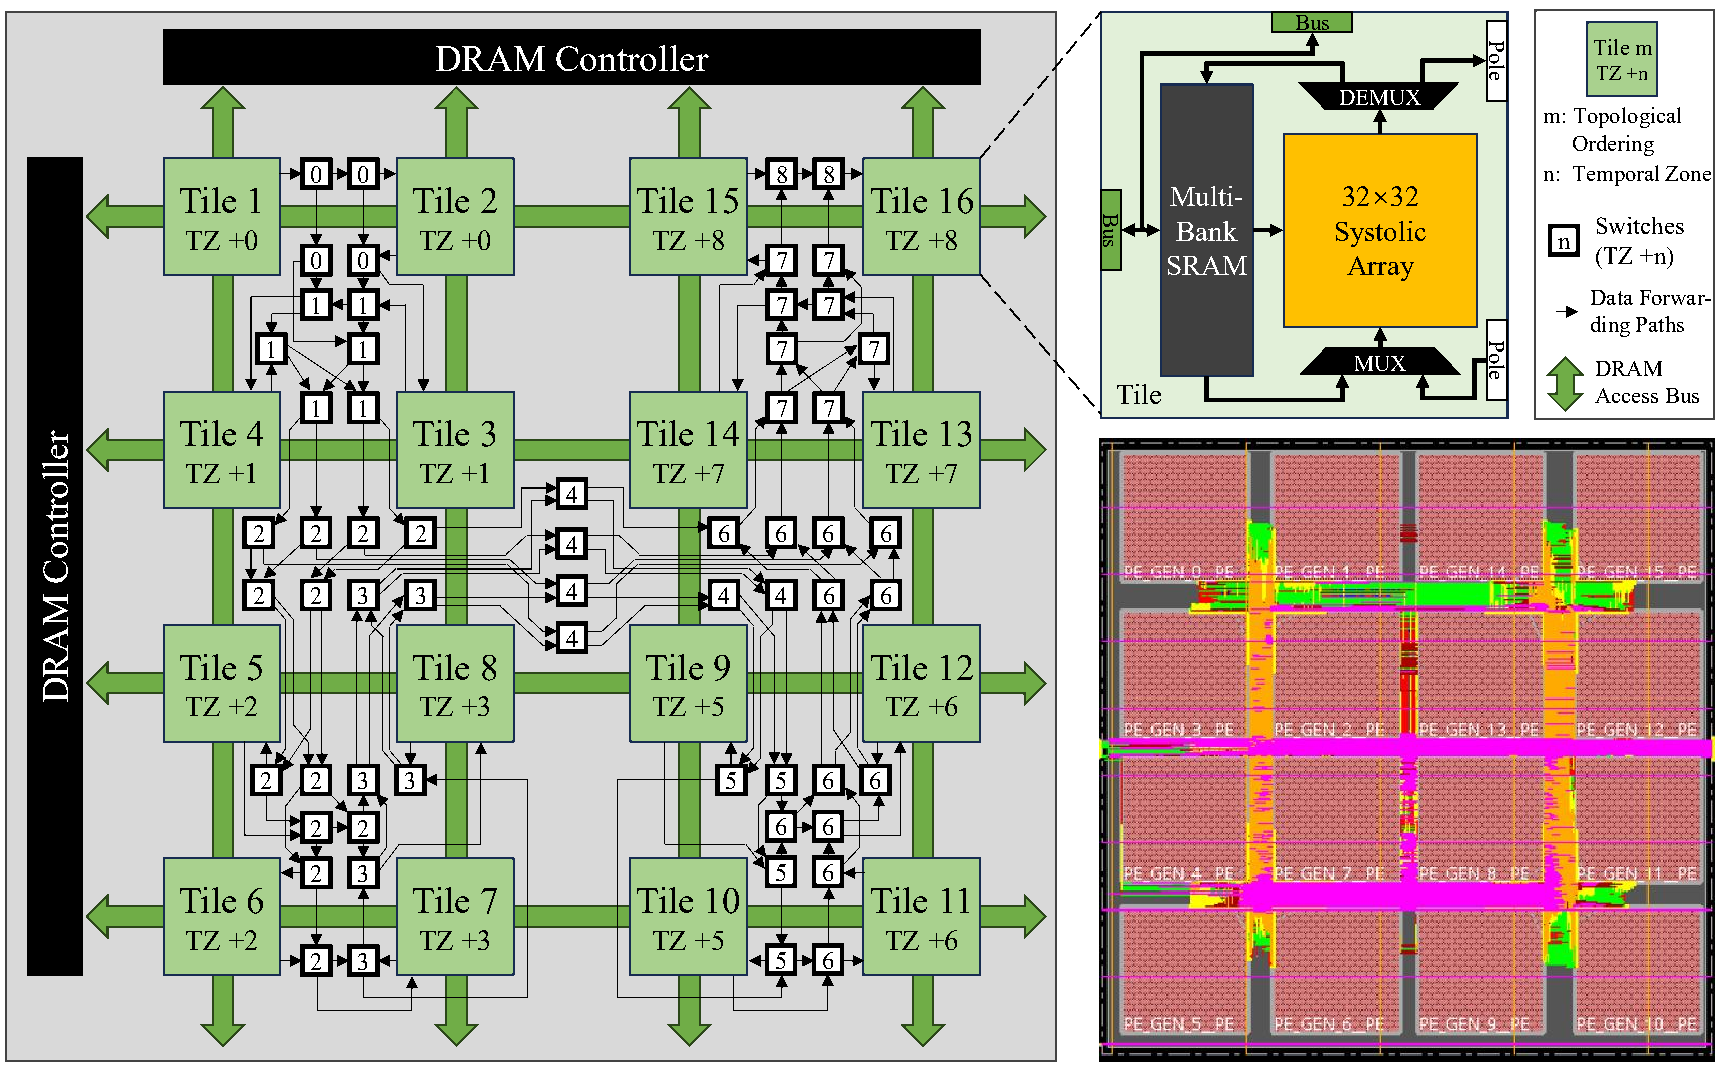
整张核间网络占 1.06 mm²,相当于 16 个计算核总面积的 6.44%。作为对照,SARA 的互联为 3.17 mm²,所评估的 Butterfly 和 Crossbar 互联都在 5.85 mm² 左右。这些路由开关与最初的UC结构基本是一致的,只是它们连接的东西从单个逻辑门换成了一整块矩阵核,开销便被摊薄到不再那么可怕了。
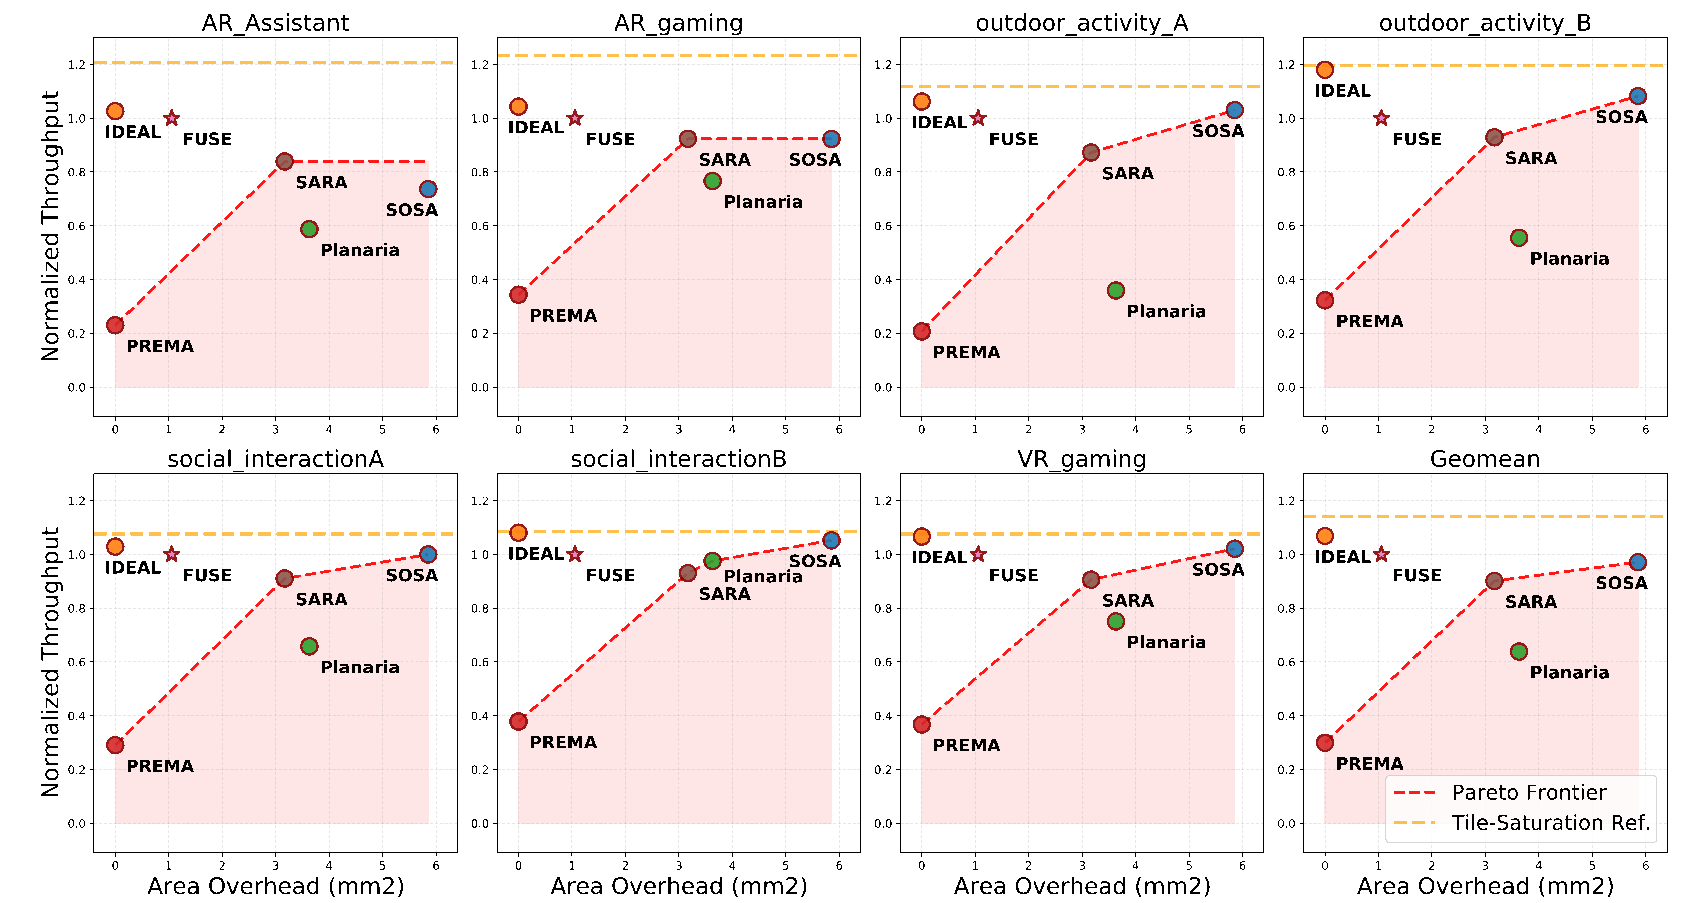
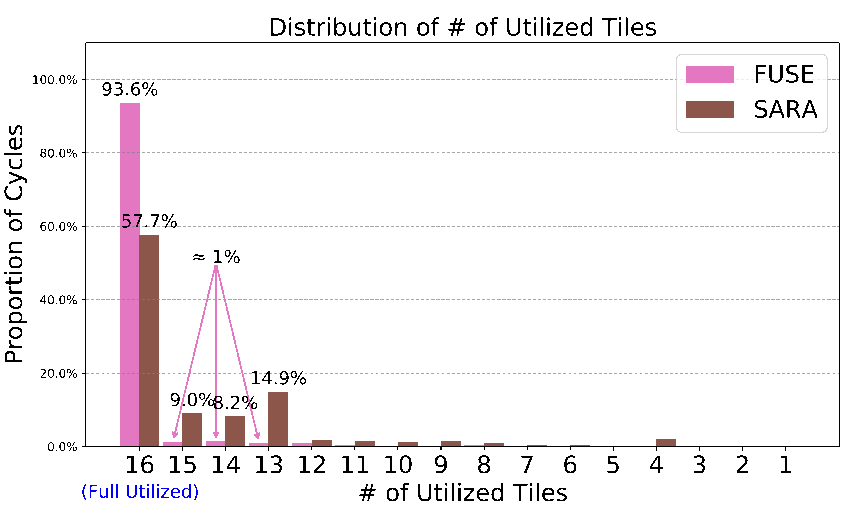
我们用 XRBench 的七组多任务负载进行周期精确仿真,以至少 95% 的任务按时完成为约束,测试能够支持的最大帧率倍率。FUSE 的几何平均吞吐量比 SARA 高约 11%。利用率统计则更直观:汇总各组负载与 QoS 设置,在至少有一个核工作的周期中,有 93.6% 的周期是 16 个核同时工作。
沿着这个思路,我们还可以考虑针对 Mesh 嵌入做一些额外的特化。相关研究已经在开展,希望尽早能够发表。
大模型时代,这种小巧思的意义在下降。模型一大,片内怎么互联好像也没差什么,一切都卡在更高的密度、更大的容量、更宽的访存上,无疑是进入体系结构的末法时代了。但是我还是很看重这项研究。我单纯地期望更多人能知道这个结构,只是因为它很漂亮,大家值得知道。
论文发表在 MICRO 2026。[PDF]